Część 1: Uruchomienie demonstracyjnego pipeline'u
Tłumaczenie wspomagane przez AI - dowiedz się więcej i zasugeruj ulepszenia
W tej pierwszej części kursu „Use nf-core" pokazujemy Ci, jak znaleźć pipeline nf-core i wypróbować go przy użyciu wbudowanego profilu testowego.
Będziemy korzystać z pipeline'u o nazwie nf-core/demo, który jest utrzymywany przez projekt nf-core jako część jego zbioru pipeline'ów do celów demonstracyjnych i szkoleniowych.
Upewnij się, że Twój katalog roboczy jest ustawiony na nfcore-use/, zgodnie z instrukcją na stronie Pierwsze kroki.
1. Znajdowanie i pobieranie pipeline'u nf-core/demo
Zacznijmy od zlokalizowania pipeline'u nf-core/demo na stronie projektu pod adresem nf-co.re, która centralizuje wszystkie informacje, takie jak: ogólna dokumentacja i artykuły pomocnicze, dokumentacja poszczególnych pipeline'ów, wpisy na blogu, ogłoszenia o wydarzeniach i inne.
1.1. Znajdowanie pipeline'u na stronie
W przeglądarce internetowej przejdź na stronę https://nf-co.re/pipelines/ i wpisz demo w pasku wyszukiwania.
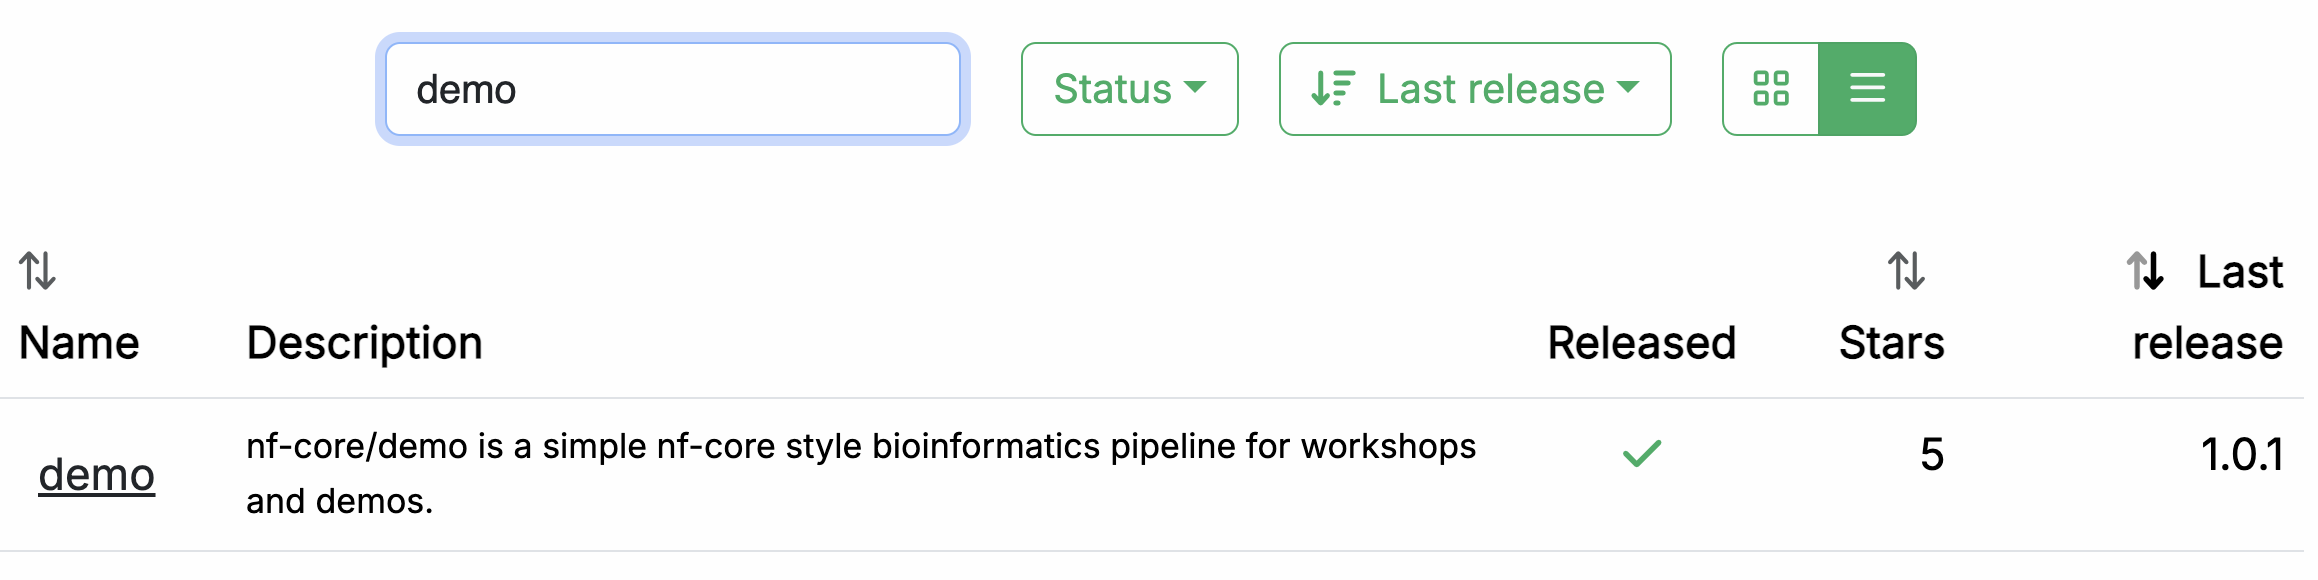
Kliknij nazwę pipeline'u, demo, aby przejść do strony z jego dokumentacją.
Każdy wydany pipeline ma dedykowaną stronę zawierającą następujące sekcje dokumentacji:
- Introduction: Wprowadzenie i przegląd pipeline'u
- Usage: Opis sposobu uruchamiania pipeline'u
- Parameters: Pogrupowane parametry pipeline'u wraz z opisami
- Output: Opisy i przykłady oczekiwanych plików wyjściowych
- Results: Przykładowe pliki wyjściowe wygenerowane z pełnego zestawu danych testowych
- Releases & Statistics: Historia wersji pipeline'u i statystyki
Przed podjęciem decyzji o użyciu nowego pipeline'u zawsze należy najpierw uważnie przeczytać jego dokumentację, aby zrozumieć, co robi i jak powinien być skonfigurowany.
Przyjrzyj się teraz i sprawdź, czy potrafisz ustalić:
- Jakie narzędzia uruchamia pipeline (sprawdź zakładkę:
Introduction) - Jakie wejścia i parametry pipeline akceptuje lub wymaga (sprawdź zakładkę:
Parameters) - Jakie wyjścia produkuje pipeline (sprawdź zakładkę:
Output)
1.1.1. Przegląd pipeline'u
Zakładka Introduction zawiera przegląd pipeline'u, w tym wizualną reprezentację (zwaną mapą metra) oraz listę narzędzi uruchamianych w ramach pipeline'u.
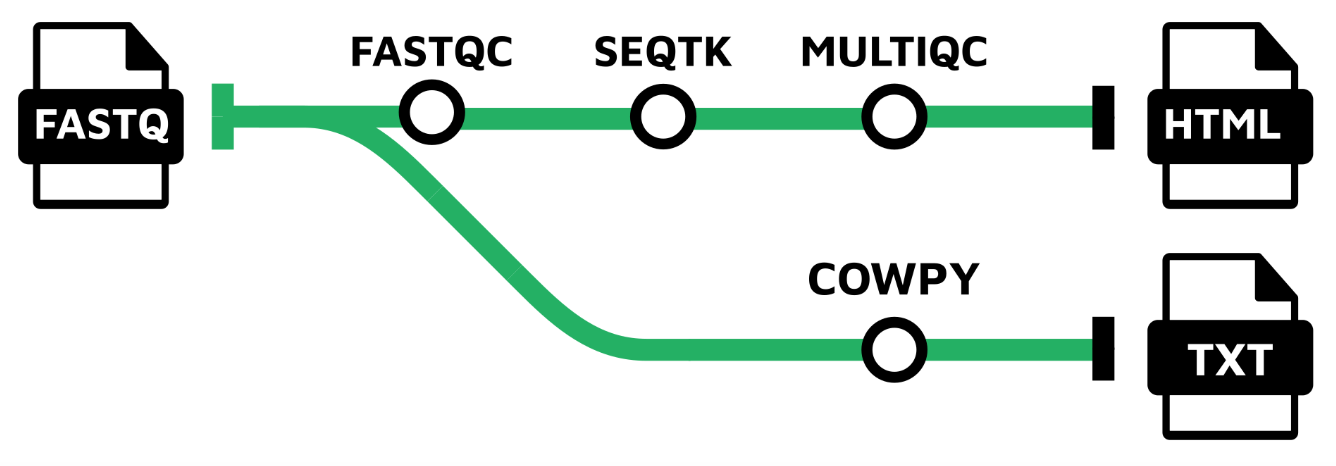
- Kontrola jakości odczytów (FASTQC)
- Przycinanie adapterów i jakości (SEQTK_TRIM)
- Prezentacja kontroli jakości surowych odczytów (MULTIQC)
- Generowanie zabawnej wiadomości tekstowej od krowy (COWPY)
1.1.2. Przykładowe polecenie
Dokumentacja zawiera również przykładowy plik wejściowy (omówiony dalej poniżej) oraz przykładowe polecenie.
nextflow run nf-core/demo \
  -profile <docker/singularity/.../institute> \
  --input samplesheet.csv \
  --outdir <OUTDIR>
Zauważysz, że przykładowe polecenie NIE wskazuje pliku workflow'u, a jedynie odwołanie do repozytorium pipeline'u, nf-core/demo.
Wywołany w ten sposób Nextflow zakłada, że kod jest zorganizowany w określony sposób. Pobierzmy kod, żeby móc przyjrzeć się tej strukturze.
1.2. Pobieranie kodu pipeline'u
Gdy już ustaliliśmy, że pipeline wydaje się odpowiedni do naszych celów, wypróbujmy go. Na szczęście Nextflow ułatwia pobieranie pipeline'ów z odpowiednio sformatowanych repozytoriów bez konieczności ręcznego pobierania czegokolwiek.
1.2.1. Użycie nextflow pull
Wróćmy do terminala i uruchommy następujące polecenie:
Wyjście polecenia
Nextflow wykonuje pull kodu pipeline'u, co oznacza pobranie całego repozytorium na lokalny dysk.
Warto zaznaczyć, że można to zrobić z dowolnym pipeline'em Nextflow odpowiednio skonfigurowanym w GitHub, nie tylko z pipeline'ami nf-core. nf-core jest jednak największą kolekcją pipeline'ów Nextflow o otwartym kodzie źródłowym.
1.2.2. Użycie nextflow list
Możesz poprosić Nextflow o wyświetlenie listy pobranych w ten sposób pipeline'ów:
Możesz spróbować pobrać kilka innych pipeline'ów, żeby zobaczyć, jak są wyświetlane, gdy masz ich więcej niż jeden.
1.2.3. Znajdowanie miejsca pobrania pipeline'u
Zauważysz, że pliki nie znajdują się w Twoim bieżącym katalogu roboczym.
Domyślnie Nextflow zapisuje pobrane pipeline'y w katalogu $NXF_HOME/assets.
Aby dowiedzieć się, gdzie znajduje się konkretny pipeline, zapytaj Nextflow bezpośrednio:
Wyjście polecenia
 project name: nf-core/demo
 repository  : https://github.com/nf-core/demo
 local path  : /workspaces/.nextflow/assets/.repos/nf-core/demo
 main script : main.nf
 description : An nf-core demo pipeline
 revisions   :
   TEMPLATE
   bumper
   dev
   fix-nxfversion
   manually-merge-3_0_2
 > master (default)
   nf-core-template-merge-2.13.2.dev0
   nf-core-template-merge-2.14.0
   nf-core-template-merge-2.14.1
   nf-core-template-merge-3.0.0
   nf-core-template-merge-3.0.1
   nf-core-template-merge-3.0.2
   nf-core-template-merge-3.1.0
   nf-core-template-merge-3.1.2
   nf-core-template-merge-3.2.0
   nf-core-template-merge-3.2.1
   nf-core-template-merge-3.3.1
   nf-core-template-merge-3.3.2
   nf-core-template-merge-4.0.0
   nf-core-template-merge-4.0.3
   nf-core-template-merge-4.1.0
   nf-core-template-merge-4.1.0-2
   patch
   1.0.0 [t]
   1.0.1 [t]
   1.0.2 [t]
   1.1.0 [t]
 > 1.2.0 [t]
Info
Pełna ścieżka może się różnić w Twoim systemie, jeśli nie korzystasz z naszego środowiska szkoleniowego.
Nextflow celowo przechowuje pobrany kod źródłowy „z dala od oczu", kierując się zasadą, że pipeline'y powinny być używane bardziej jak biblioteki niż kod, z którym bezpośrednio się pracuje.
Pod spodem Nextflow przechowuje każdy pobrany pipeline jako repozytorium git w katalogu $NXF_HOME/assets/.repos/, a kod każdej wersji jest wyewidencjonowywany do podkatalogu clones/<commit>/.
Ponieważ .repos jest ukrytym katalogiem, zwykłe polecenie tree -L 2 $NXF_HOME/assets/ wyświetli pusty wynik.
1.2.4. Tworzenie dowiązania symbolicznego dla łatwego dostępu do kodu źródłowego
Nie będziemy szczegółowo analizować kodu, ale rzućmy na niego okiem, żeby zorientować się, jak wygląda ogólna organizacja.
Aby ułatwić przeglądanie kodu źródłowego pipeline'u, utwórz dowiązanie symboliczne wskazujące na wyewidencjonowaną kopię pipeline'u:
mkdir -p pipelines/nf-core
ln -s "$(echo $NXF_HOME/assets/.repos/nf-core/demo/clones/*/)" pipelines/nf-core/demo
Tworzy to skrót, dzięki któremu możesz przeglądać kod za pomocą tree -L 2 pipelines/nf-core/demo lub otwierać pliki bezpośrednio.
1.2.5. Przegląd organizacji kodu
Możesz użyć polecenia tree lub eksploratora plików, aby znaleźć i otworzyć katalog nf-core/demo.
Zawartość katalogu
pipelines/nf-core/demo
├── assets
├── CHANGELOG.md
├── CITATIONS.md
├── CODE_OF_CONDUCT.md
├── conf
├── docs
├── LICENSE
├── main.nf
├── modules
├── modules.json
├── nextflow.config
├── nextflow_schema.json
├── nf-test.config
├── README.md
├── ro-crate-metadata.json
├── subworkflows
├── tests
├── tower.yml
└── workflows

7 directories, 12 files
Jak widać, dzieje się tam całkiem sporo, choć większość z tego nie wymaga Twojej uwagi.
Krótko mówiąc, na najwyższym poziomie znajdziesz plik README z informacjami podsumowującymi, a także pliki pomocnicze zawierające informacje o projekcie, takie jak licencja, wytyczne dotyczące wkładu, cytowania i kodeks postępowania.
Szczegółowa dokumentacja pipeline'u znajduje się w katalogu docs.
Cała ta zawartość jest używana do programowego generowania stron internetowych na stronie nf-core, dzięki czemu są one zawsze aktualne względem kodu.
W pozostałej części możemy wyróżnić trzy funkcjonalne grupy plików z kodem:
- Komponenty kodu pipeline'u (
main.nf,workflows,subworkflows,modules) - Konfiguracja pipeline'u
- Parametry / wejścia pipeline'u i ich walidacja
W tej części kursu nie będziemy omawiać komponentów kodu pipeline'u, ale dotkniemy elementów konfiguracji i walidacji, które mogą być istotne dla Ciebie jako użytkownika końcowego pipeline'ów nf-core.
Wskazówka
Możesz też przeglądać kod źródłowy dowolnego pipeline'u nf-core na GitHub, np. github.com/nf-core/demo. Każdy pipeline nf-core ma taki sam układ katalogów, więc gdy już znasz tę strukturę, możesz w ten sam sposób znajdować pliki konfiguracyjne, moduły i workflow'y dla dowolnego pipeline'u.
Na razie przejdźmy do uruchamiania pipeline'u!
Podsumowanie
Wiesz już, jak znaleźć pipeline na stronie nf-core i pobrać lokalną kopię jego kodu źródłowego.
Co dalej?
Dowiedz się, jak wypróbować pipeline nf-core przy minimalnym nakładzie pracy.
2. Wypróbowanie pipeline'u z jego profilem testowym
Każdy pipeline nf-core jest wygodnie wyposażony w profil testowy. Jest to minimalny zestaw ustawień konfiguracyjnych umożliwiający uruchomienie pipeline'u z małym zestawem danych testowych hostowanym w repozytorium nf-core/test-datasets. To świetny sposób na szybkie wypróbowanie pipeline'u na małą skalę.
Wskazówka
System profili konfiguracyjnych Nextflow pozwala łatwo przełączać się między różnymi silnikami kontenerów lub środowiskami wykonawczymi. Więcej szczegółów znajdziesz w Hello Nextflow Część 6: Konfiguracja.
2.1. Analiza profilu testowego
Dobrą praktyką jest sprawdzenie, co określa profil testowy pipeline'u przed jego uruchomieniem.
Profil test dla nf-core/demo znajduje się w pliku konfiguracyjnym conf/test.config.
Możesz go znaleźć lokalnie w kodzie źródłowym pipeline'u pobranym przez nextflow pull, za pośrednictwem dowiązania symbolicznego pipelines utworzonego w sekcji 1.2.4:
Oto zawartość tego pliku:
Od razu zauważysz, że blok komentarza na górze zawiera przykład użycia pokazujący, jak uruchomić pipeline z tym profilem testowym.
| conf/test.config | |
|---|---|
Jedyne, co musimy podać, to to, co widnieje między nawiasami ostrymi w przykładowym poleceniu: <docker/singularity> i <OUTDIR>.
Przypomnijmy, że <docker/singularity> odnosi się do wyboru systemu kontenerów. Wszystkie pipeline'y nf-core są zaprojektowane do użytku z kontenerami (Docker, Singularity itp.) w celu zapewnienia odtwarzalności i wyeliminowania problemów z instalacją oprogramowania.
Musimy więc określić, czy chcemy użyć Docker, czy Singularity do przetestowania pipeline'u.
Część --outdir <OUTDIR> odnosi się do katalogu, w którym Nextflow zapisze wyjścia pipeline'u.
Musimy podać dla niego nazwę, którą możemy po prostu wymyślić.
Jeśli katalog jeszcze nie istnieje, Nextflow utworzy go dla nas w czasie wykonywania.
Przechodząc do sekcji po bloku komentarza, profil testowy pokazuje nam, co zostało wstępnie skonfigurowane do testowania: przede wszystkim parametr input jest już ustawiony tak, aby wskazywał na zestaw danych testowych, więc nie musimy dostarczać własnych danych.
Jeśli przejdziesz pod wstępnie skonfigurowany link wejściowy, zobaczysz, że jest to plik CSV zawierający identyfikatory próbek i ścieżki do plików dla kilku próbek eksperymentalnych.
sample,fastq_1,fastq_2
SAMPLE1_PE,https://raw.githubusercontent.com/nf-core/test-datasets/viralrecon/illumina/amplicon/sample1_R1.fastq.gz,https://raw.githubusercontent.com/nf-core/test-datasets/viralrecon/illumina/amplicon/sample1_R2.fastq.gz
SAMPLE2_PE,https://raw.githubusercontent.com/nf-core/test-datasets/viralrecon/illumina/amplicon/sample2_R1.fastq.gz,https://raw.githubusercontent.com/nf-core/test-datasets/viralrecon/illumina/amplicon/sample2_R2.fastq.gz
SAMPLE3_SE,https://raw.githubusercontent.com/nf-core/test-datasets/viralrecon/illumina/amplicon/sample1_R1.fastq.gz,
SAMPLE3_SE,https://raw.githubusercontent.com/nf-core/test-datasets/viralrecon/illumina/amplicon/sample2_R1.fastq.gz,
Taki plik nazywa się samplesheet i jest najczęstszą formą wejścia do pipeline'ów nf-core. Nie martw się, jeśli nie znasz formatów i typów danych — nie jest to istotne dla dalszej części.
Mamy teraz wszystko, czego potrzebujemy, żeby wypróbować pipeline.
2.2. Uruchamianie pipeline'u
Jak wspomniano powyżej, możemy użyć przykładowego polecenia testowego niemal bez zmian; wystarczy określić, jakiego pakowania oprogramowania użyć i jak nazwać katalog wyjściowy.
Użyjemy Docker jako systemu kontenerów i nazwy demo-results.
Możemy teraz uruchomić polecenie testowe:
Wyjście polecenia
 N E X T F L O W   ~  version 26.04.4

Downloading plugin nf-schema@2.7.2
Launching `https://github.com/nf-core/demo` [cranky_curry] revision: 32893afef8 [master]


------------------------------------------------------
                                        ,--./,-.
        ___     __   __   __   ___     /,-._.--~'
  |\ | |__  __ /  ` /  \ |__) |__         }  {
  | \| |       \__, \__/ |  \ |___     \`-._,-`-,
                                        `._,._,'
  nf-core/demo 1.2.0
------------------------------------------------------

Input/output options
  input                     : https://raw.githubusercontent.com/nf-core/test-datasets/viralrecon/samplesheet/samplesheet_test_illumina_amplicon.csv
  outdir                    : demo-results

Institutional config options
  config_profile_name       : Test profile
  config_profile_description: Minimal test dataset to check pipeline function

Generic options
  trace_report_suffix       : 2026-07-03_21-31-35

Core Nextflow options
  revision                  : master
  runName                   : cranky_curry
  containerEngine           : docker
  launchDir                 : /workspaces/training/nfcore-use
  workDir                   : /workspaces/training/nfcore-use/work
  projectDir                : /workspaces/.nextflow/assets/.repos/nf-core/demo/clones/32893afef8076a03a2767a020b3f0cab2e0b40b2
  userName                  : root
  profile                   : test,docker
  configFiles               : /workspaces/.nextflow/assets/.repos/nf-core/demo/clones/32893afef8076a03a2767a020b3f0cab2e0b40b2/nextflow.config

!! Only displaying parameters that differ from the pipeline defaults !!
------------------------------------------------------

* The pipeline
    https://doi.org/10.5281/zenodo.12192442

* The nf-core framework
    https://doi.org/10.1038/s41587-020-0439-x

* Software dependencies
    https://github.com/nf-core/demo/blob/master/CITATIONS.md

executor >  local (8)
[ca/5b0f3e] NFCORE_DEMO:DEMO:FASTQC (SAMPLE3_SE)     | 3 of 3 ✔
[b7/cb6812] NFCORE_DEMO:DEMO:SEQTK_TRIM (SAMPLE3_SE) | 3 of 3 ✔
[ff/6ebd98] NFCORE_DEMO:DEMO:COWPY                   | 1 of 1 ✔
[09/bbd1b4] NFCORE_DEMO:DEMO:MULTIQC (demo)          | 1 of 1 ✔
-[nf-core/demo] Pipeline completed successfully-
Jeśli Twój wynik jest zgodny z powyższym — gratulacje! Właśnie uruchomiłeś swój pierwszy pipeline nf-core.
Zauważysz, że na konsoli pojawia się znacznie więcej danych wyjściowych niż przy uruchamianiu podstawowego pipeline'u Nextflow. Widnieje tam nagłówek zawierający podsumowanie wersji pipeline'u, wejść i wyjść oraz kilka elementów konfiguracji.
Info
Twój wynik będzie zawierał inne znaczniki czasu, nazwy wykonań i ścieżki do plików, ale ogólna struktura i wykonanie procesów powinny być podobne.
Zwróć uwagę na wiersz blisko początku wyniku:
Informuje on, która wersja pipeline'u została użyta.
Ponieważ nie określiliśmy wersji, Nextflow użył najnowszego commitu na gałęzi master.
Dla odtwarzalnych uruchomień należy przypiąć konkretne wydanie za pomocą flagi -r:
Gwarantuje to, że za każdym razem używany jest ten sam kod pipeline'u, niezależnie od nowych commitów czy wydań.
W tym szkoleniu pomijamy -r dla uproszczenia, ale w środowisku produkcyjnym zawsze należy go podawać.
Przejdźmy teraz do wyniku wykonania i przyjrzyjmy się wierszom informującym o uruchomionych procesach:
executor >  local (8)
[ca/5b0f3e] NFCORE_DEMO:DEMO:FASTQC (SAMPLE3_SE)     | 3 of 3 ✔
[b7/cb6812] NFCORE_DEMO:DEMO:SEQTK_TRIM (SAMPLE3_SE) | 3 of 3 ✔
[ff/6ebd98] NFCORE_DEMO:DEMO:COWPY                   | 1 of 1 ✔
[09/bbd1b4] NFCORE_DEMO:DEMO:MULTIQC (demo)          | 1 of 1 ✔
-[nf-core/demo] Pipeline completed successfully-
Wynika z tego, że uruchomiono cztery procesy, odpowiadające czterem narzędziom pokazanym na stronie dokumentacji pipeline'u na stronie nf-core: FASTQC, SEQTK_TRIM, MULTIQC i COWPY.
Pełne nazwy procesów widoczne tutaj, takie jak NFCORE_DEMO:DEMO:MULTIQC, są dłuższe niż te, które mogłeś widzieć we wprowadzającym materiale Hello Nextflow.
Zawierają one nazwy nadrzędnych workflow'ów i odzwierciedlają modularność kodu pipeline'u.
Jeśli chcesz nauczyć się samodzielnie tworzyć pipeline'y w stylu nf-core, zapoznaj się z kursem Build with nf-core.
2.3. Analiza wyjść pipeline'u
Na koniec przyjrzyjmy się katalogowi demo-results wyprodukowanemu przez pipeline.
Zawartość katalogu
demo-results
├── cowpy
│   └── cowpy.txt
├── fastqc
│   ├── SAMPLE1_PE
│   ├── SAMPLE2_PE
│   └── SAMPLE3_SE
├── fq
│   ├── SAMPLE1_PE
│   ├── SAMPLE2_PE
│   └── SAMPLE3_SE
├── multiqc
│   ├── multiqc_data
│   └── multiqc_report.html
└── pipeline_info
    ├── execution_report_2026-07-03_21-31-35.html
    ├── execution_timeline_2026-07-03_21-31-35.html
    ├── execution_trace_2026-07-03_21-31-35.txt
    ├── nf_core_demo_software_mqc_versions.yml
    ├── params_2026-07-03_21-31-43.json
    └── pipeline_dag_2026-07-03_21-31-35.html

12 directories, 8 files
To może wydawać się dużo.
Aby dowiedzieć się więcej o wyjściach pipeline'u nf-core/demo, zajrzyj do jego strony dokumentacji.
Na tym etapie ważne jest, żeby zauważyć, że wyniki są zorganizowane według modułów, a dodatkowo istnieje katalog pipeline_info zawierający różne opatrzone znacznikami czasu raporty dotyczące wykonania pipeline'u.
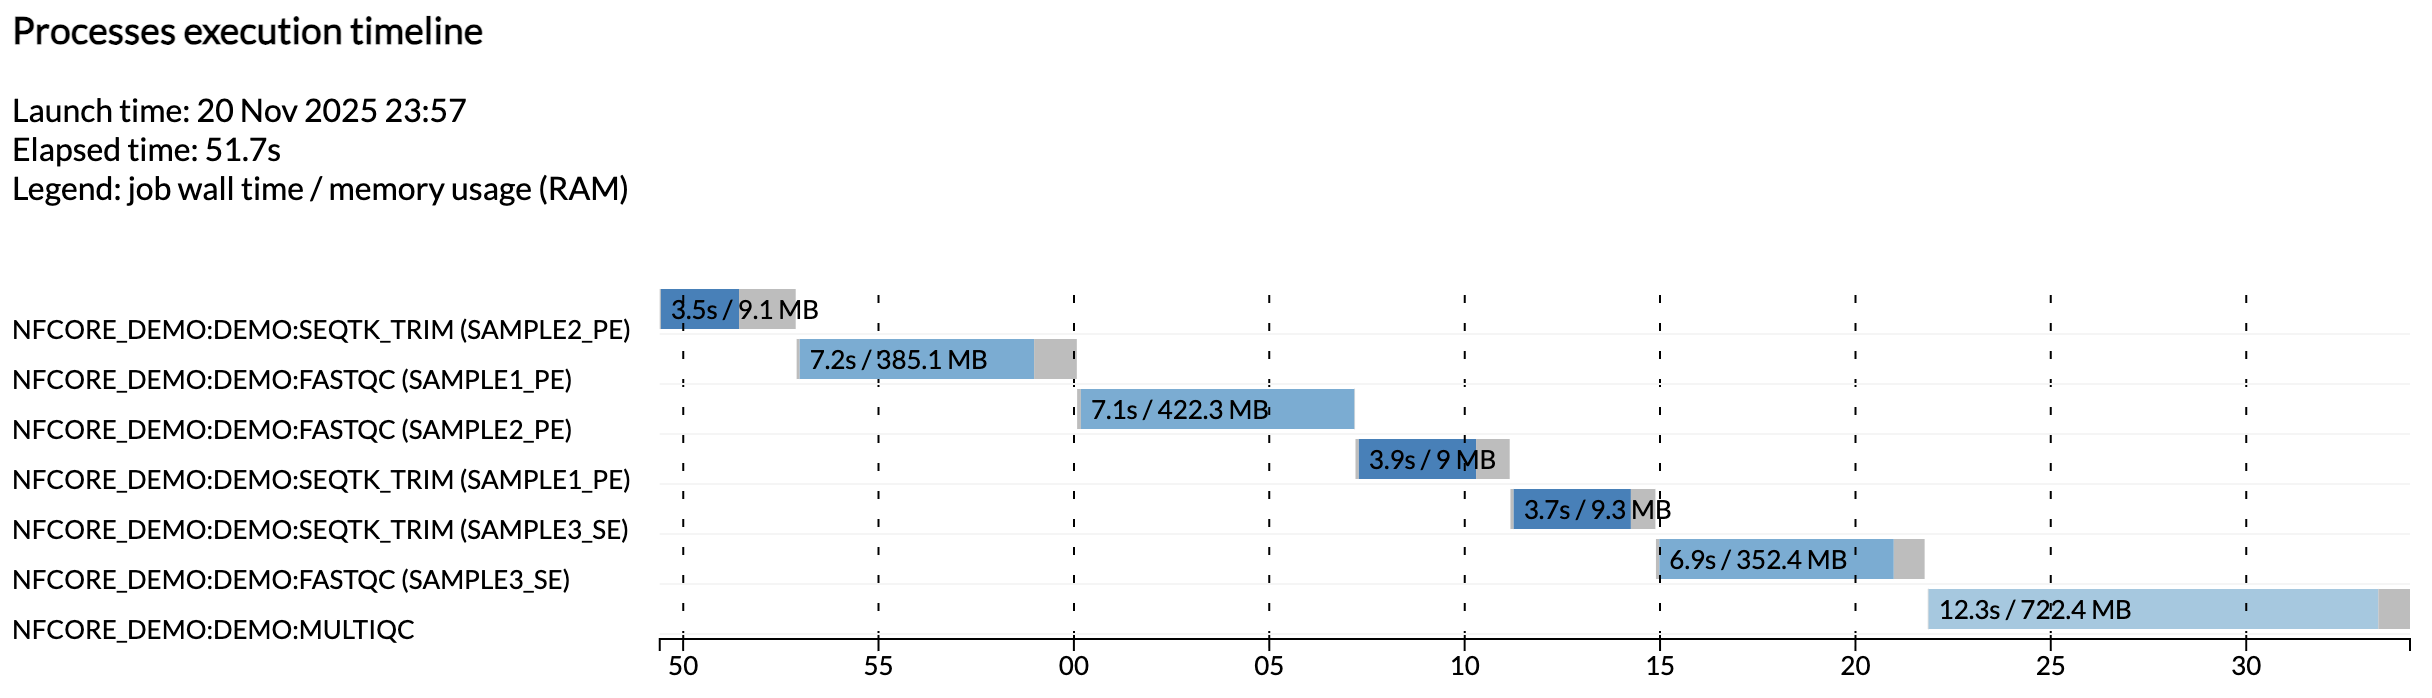
Na przykład plik execution_timeline_* pokazuje, jakie procesy zostały uruchomione, w jakiej kolejności i jak długo trwały:
Info
Zadania nie były tu uruchamiane równolegle, ponieważ działamy na minimalistycznej maszynie w Github Codespaces. Aby zobaczyć je działające równolegle, spróbuj zwiększyć przydział CPU swojego codespace'u oraz limity zasobów w konfiguracji testowej.
Raporty te są generowane automatycznie dla wszystkich pipeline'ów nf-core.
Podsumowanie
Wiesz już, jak uruchomić pipeline nf-core przy użyciu wbudowanego profilu testowego i gdzie znaleźć jego wyjścia.
Co dalej?
Przejdź do Części 2, gdzie dowiesz się, jak konfigurować wykonanie pipeline'u.
Podsumowanie
W tej części nauczyłeś się:
- Znajdować i pobierać pipeline nf-core oraz analizować jego strukturę kodu
- Uruchamiać pipeline przy użyciu wbudowanego profilu testowego